Módszer · hogyan mérünk
Hogyan mér a Makefield — a kutatás az audit mögött
A legtöbb AI-láthatósági ellenőrzés néhány képernyőkép és egy vélemény. Ez arra épült, hogy mérhető legyen — és hogy megálljon, amikor valaki ellenőrzi a mérést.
A különbség
Audit vagy mérés?
Bárki megkérdezheti a ChatGPT-t egy cégről, csinálhat egy képernyőképet, és nevezheti auditnak. A baj az, hogy egy AI-válasz mozgó, zajos dolog: napról napra változik, motoronként eltér, és két ember, aki ugyanazt a választ olvassa, másképp pontozza, hacsak előre meg nem egyeznek, mit keresnek. Egy képernyőkép ebből semmit sem él túl.
A Makefield az auditot egy kis kutatásként kezeli a cégedről — úgy mérve, hogy a szám jelentsen valamit, és úgy leírva, hogy más is ellenőrizhesse. Íme, mit jelent ez, világos szavakkal.
Mielőtt sikert állítunk
Először megbecsüljük a rezgést
Az AI-válaszok maguktól sodródnak. Tedd fel kétszer ugyanazt a kérdést, és a megfogalmazás, a nevek, sőt az ajánlás is eltolódhat, miközben a te oldaladon semmi sem változott. Mielőtt tehát azt mondanánk, egy javítás „megmozdította a választ", megbecsüljük, mennyit mozog a válasz magától — a zajküszöbét. A küszöbnél kisebb változás nem eredmény, hanem zaj. Ennek a küszöbnek a megnevezése a csendes rész, amit a legtöbb „audit" kihagy, és éppen ez teszi hihetővé a későbbi javulást.
A motorok között
Nem keverjük a motorokat, amíg nem ugyanazt jelentik
A ChatGPT, Perplexity, Claude, Gemini, Copilot és Google AI Mode elég eltérően viselkedik ahhoz, hogy egyetlen kevert érték többet rejtsen el, mint amennyit mutat. Mielőtt a motorok között összesítenénk a számokat, ellenőrizzük, hogy a mérés mindegyiken ugyanazt jelenti — és ahol nem, külön jelentjük, ahelyett, hogy elátlagolnánk a különbséget. Egy kevert szám, amit nem tudsz megvédeni, rosszabb, mint hat őszinte.
Hogy egy másik ember is egyetértsen
Rács alapján pontozunk, nem megérzésből
Minden dimenziót rögzített, kalibrált skálán pontozunk, a tényleges válaszra alkalmazva, a cég nevét kimaszkolva, hogy a márka ismertsége ne befolyásolja az értékelést. Minden publikált állításhoz megmérjük, mennyire értenek egyet a független értékelők — valódi egyetértési statisztika, az eredményével együtt nyilvánosságra hozva — ahelyett, hogy egyetlen megítélésben való bizalmat kérnénk. A cél nem technikásnak hangzani; egy megbízható szám az, amely nem függ attól, ki tartotta a tollat.
Bizonyíték, nem állítás
Megmutatjuk, hogy megmozdult — és mennyivel
A munka nem ér véget a „javításokat végeztünk"-nél. Újrafuttatjuk ugyanazt a kiindulási auditot, és összehasonlítjuk. Hogy egy konkrét változást egy konkrét nyereséghez kössünk — ami nehéz, mert egy munkakör egyszerre sok változtatást szállít — olyan elrendezésekre támaszkodunk, amelyek pontosan erre valók: a mutatót időben követve, és a változás pillanatában bekövetkező törésre figyelve (megszakított idősor), valamint egyváltozós elrendezésekre, amelyek egyszerre egy dolgot változtatnak. És jelentjük, mekkora volt a hatás, nem csak azt, hogy felment. A „nagyobb, mint a zajküszöb, ennyivel" állítás; a „javult" megérzés.
A helyeset mérni
Ellenőrizzük, hogy az érték valóban a láthatóságot ragadja meg
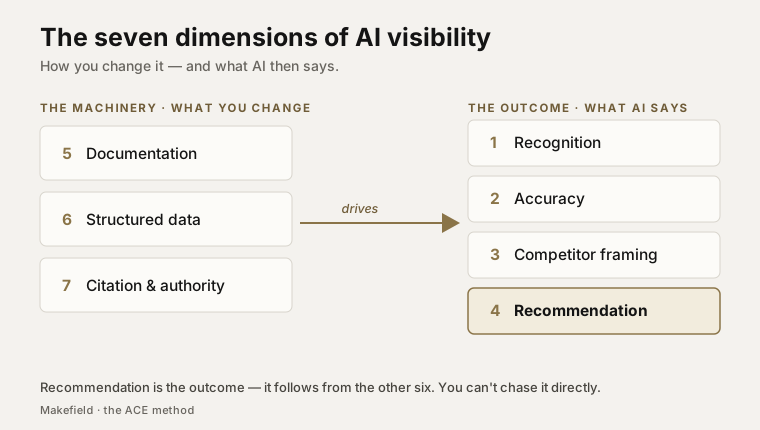
Egy érték csak akkor ér valamit, ha azt méri, amit állít. A Makefield auditja hét dimenziót fed le — felismerés, pontosság, versenytárs-keretezés és ajánlás (az eredmény), valamint dokumentáció, strukturált adatok és hivatkozás/tekintély (a gépezet). Ahogy egy adathalmaz nő, teszteljük, hogy ezek a dimenziók úgy függnek-e össze, ahogy a modell állítja — és amint egy valós üzleti eredmény látótávolságba kerül, mennyit tud belőle magyarázni az érték. Ahol a bizonyíték még hiányzik, ezt világosan kimondjuk, ahelyett, hogy egy feltevést megállapításnak öltöztetnénk.
Nyíltan
Előbb a fenntartások — és publikáljuk, ami nem működött
Minden tanulmány és audit a mintájával és a korlátaival kezd, nem a főcímmel. A megfigyelések dátumozottak, forrásoltak és képernyőképekkel alátámasztottak, hogy a munka reprodukálható legyen. És amikor egy hatást várunk, de semmit sem találunk, azt is publikáljuk — egy negatív eredmény őszinte, ezen a területen ritka, és többet ér egy magabiztos túlzásnál.
Miért van itt
Nyílt, és ingyenes
Ezt oktatási anyagként publikáljuk, mert a terület tele van magabiztos állítással és szegény a mérésben — és ez egy olyan probléma, amit érdemes nyilvánosan megoldani. A módszer a nyílt kurzuson, a megállapítások a terepjegyzetekben, a definíciók a referenciában, az audit-keretrendszer pedig a GitHubon. Kiadja a Makefield, Berlin. Szabadon olvasható, használható és forrásmegjelöléssel hivatkozható — nincs semmi eladó.