Methode · wie wir messen
Wie Makefield misst — die Forschung hinter dem Audit
Die meisten KI-Sichtbarkeits-Checks sind ein paar Screenshots und eine Meinung. Dieser ist gebaut, um gemessen zu werden — und um standzuhalten, wenn jemand die Messung prüft.
Der Unterschied
Ein Audit oder eine Messung?
Jeder kann ChatGPT nach einem Unternehmen fragen, einen Screenshot machen und das ein Audit nennen. Das Problem: Eine KI-Antwort ist beweglich und verrauscht — sie ändert sich von einem Tag zum nächsten, sie unterscheidet sich zwischen Engines, und zwei Menschen, die dieselbe Antwort lesen, bewerten sie unterschiedlich, sofern sie sich nicht vorher einigen, worauf sie achten. Ein Screenshot übersteht nichts davon.
Makefield behandelt ein Audit als kleines Stück Forschung über dein Unternehmen — so gemessen, dass die Zahl etwas bedeutet, und so geschrieben, dass jemand anderes sie prüfen könnte. So sieht das aus, in klaren Worten.
Bevor wir einen Erfolg behaupten
Wir schätzen zuerst das Wackeln
KI-Antworten driften von selbst. Stelle dieselbe Frage zweimal, und die Formulierung, die Namen, sogar die Empfehlung können sich verschieben, ohne dass sich auf deiner Seite etwas geändert hat. Bevor wir also sagen, ein Fix habe „die Antwort bewegt", schätzen wir, wie stark sich die Antwort von selbst bewegt — ihren Rauschpegel. Eine Veränderung kleiner als dieses Wackeln ist kein Ergebnis, sondern Rauschen. Diesen Pegel zu benennen, ist der stille Teil, den die meisten „Audits" überspringen, und genau er macht eine spätere Verbesserung glaubwürdig.
Über Engines hinweg
Wir mischen Engines nicht, bevor sie dasselbe meinen
ChatGPT, Perplexity, Claude, Gemini, Copilot und Google AI Mode verhalten sich unterschiedlich genug, dass ein einzelner Mischwert mehr verbergen als zeigen kann. Bevor wir Zahlen über Engines hinweg zusammenfassen, prüfen wir, ob die Messung auf jeder dasselbe meint — und wo nicht, berichten wir sie getrennt, statt den Unterschied wegzumitteln. Ein Mischwert, den du nicht verteidigen kannst, ist schlechter als sechs ehrliche.
Damit ein anderer zustimmt
Wir bewerten gegen ein Raster, nicht nach Gefühl
Jede Dimension wird auf einer festen, kalibrierten Skala bewertet, angewandt auf die tatsächliche Antwort, mit maskiertem Firmennamen, damit Markenvertrautheit die Bewertung nicht verzerrt. Für jede Behauptung, die wir veröffentlichen, messen wir, wie gut unabhängige Bewerter übereinstimmen — eine echte Übereinstimmungsstatistik, offengelegt samt Ergebnis — statt dich um Vertrauen in eine einzelne Einschätzung zu bitten. Es geht nicht darum, technisch zu klingen; eine verlässliche Zahl ist eine, die nicht davon abhängt, wer den Stift hielt.
Beleg, nicht Behauptung
Wir zeigen, dass sich etwas bewegt hat — und wie viel
Die Arbeit endet nicht bei „wir haben Fixes gemacht". Wir führen dasselbe Baseline-Audit erneut durch und vergleichen. Um eine konkrete Veränderung mit einem konkreten Gewinn zu verbinden — schwer, weil eine Arbeitsrunde viele Änderungen auf einmal ausliefert — stützen wir uns auf Designs, die genau dafür gebaut sind: die Kennzahl über die Zeit verfolgen und auf einen Bruch im Moment der Änderung achten (eine unterbrochene Zeitreihe) und Einzelfall-Designs, die eine Sache nach der anderen ändern. Und wir berichten, wie groß der Effekt war, nicht nur, dass er nach oben ging. „Größer als der Rauschpegel, um diesen Betrag" ist eine Aussage; „es hat sich verbessert" ist ein Gefühl.
Das Richtige messen
Wir prüfen, ob der Wert wirklich Sichtbarkeit erfasst
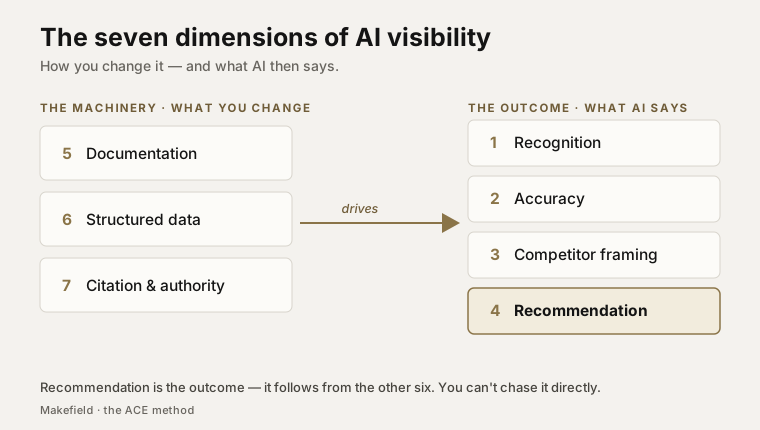
Ein Wert ist nur etwas wert, wenn er misst, was er zu messen vorgibt. Makefields Audit umfasst sieben Dimensionen — Erkennung, Genauigkeit, Wettbewerbseinordnung und Empfehlung (das Ergebnis) sowie Dokumentation, strukturierte Daten und Zitierung/Autorität (die Maschinerie). Wächst ein Datensatz, testen wir, ob diese Dimensionen so zusammenhängen, wie das Modell es behauptet — und, sobald ein echtes Geschäftsergebnis in Sicht ist, wie viel dieses Ergebnisses der Wert tatsächlich erklären kann. Wo die Belege noch fehlen, sagen wir das klar, statt eine Annahme als Erkenntnis zu verkleiden.
Offen
Erst die Vorbehalte — und wir veröffentlichen, was nicht funktioniert hat
Jede Studie und jedes Audit führt mit seiner Stichprobe und seinen Grenzen, nicht mit der Schlagzeile. Beobachtungen sind datiert, mit Quellen versehen und durch Screenshots belegt, damit die Arbeit reproduzierbar ist. Und wenn wir einen Effekt erwarten und nichts finden, veröffentlichen wir auch das — ein negatives Ergebnis ist ehrlich, in diesem Feld selten und mehr wert als eine selbstbewusste Übertreibung.
Warum es hier steht
Offen, und kostenlos
Das wird als Lehrmaterial veröffentlicht, weil das Feld voller selbstbewusster Behauptungen und arm an Messung ist — und das ist ein Problem, das sich lohnt, öffentlich zu lösen. Die Methode steht im offenen Kurs, die Erkenntnisse in den Feldnotizen, die Definitionen in der Referenz und das Audit-Framework auf GitHub. Herausgegeben von Makefield, Berlin. Frei zu lesen, zu nutzen und mit Quellenangabe zu zitieren — es gibt nichts zu kaufen.